Qué pasó
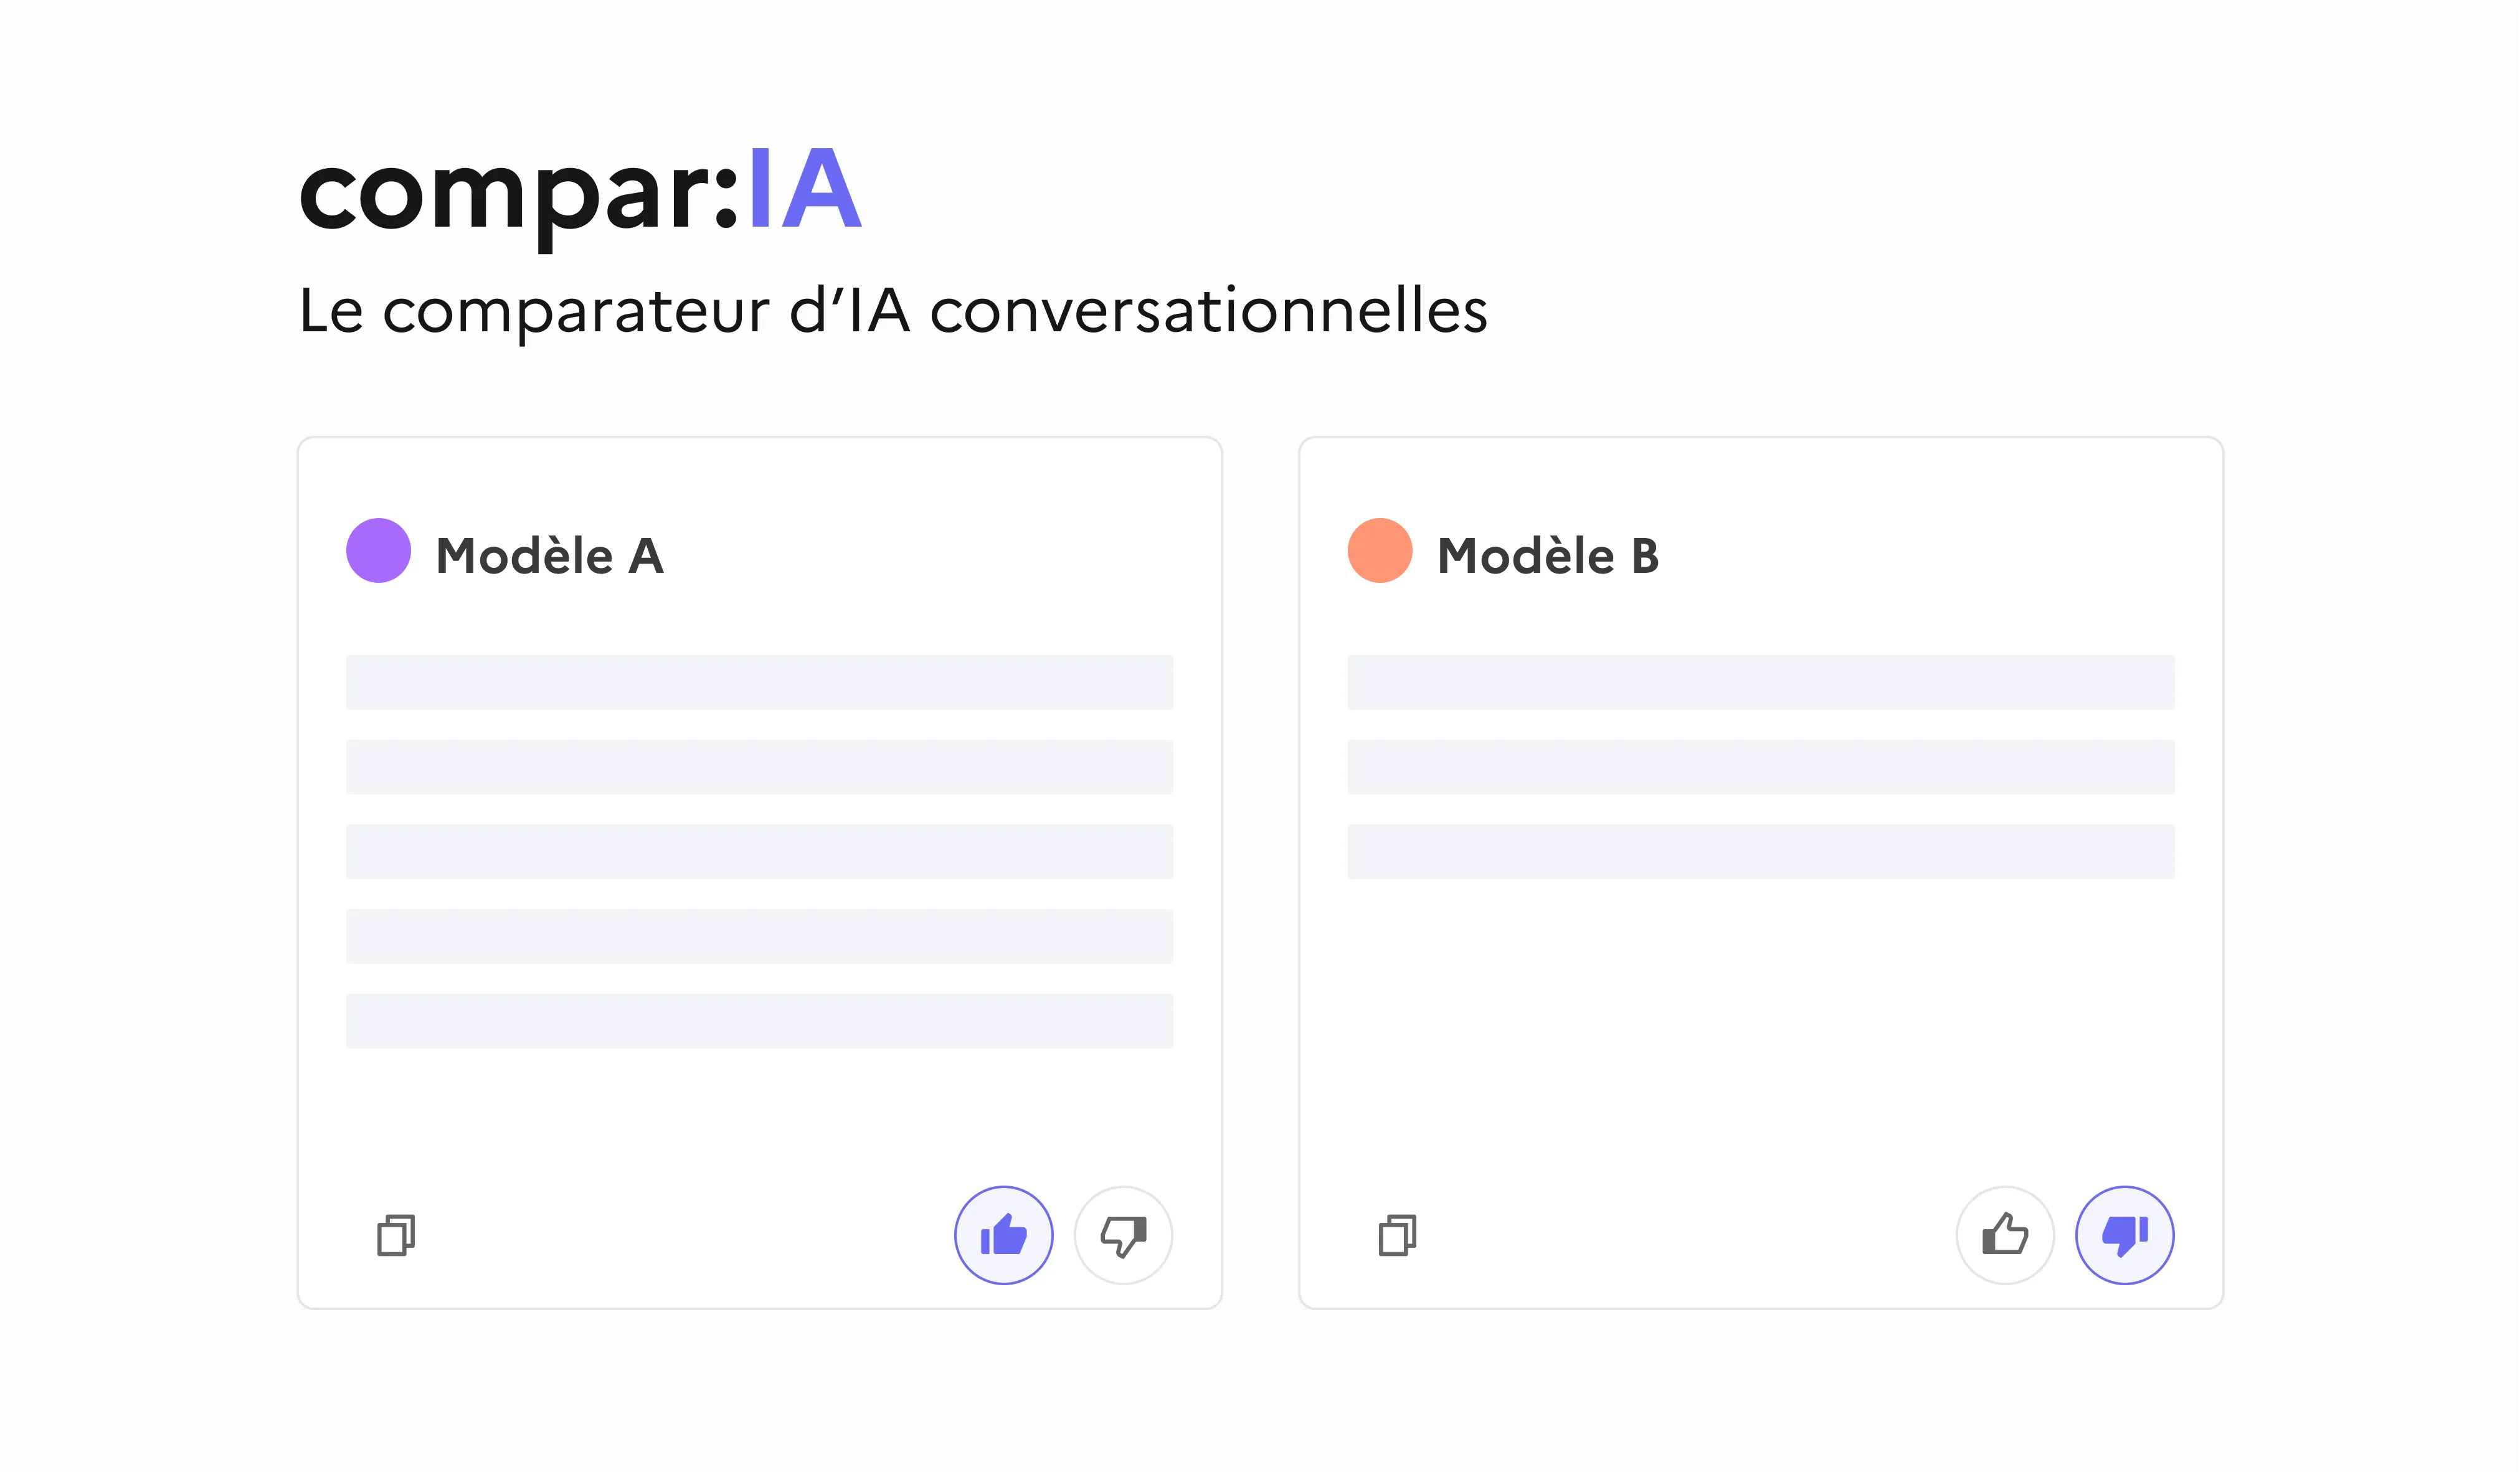
- Simonas Zilinskas, Maayeesha Farzana y Christophe Benavent publicaron el 2 de octubre de 2026 en arXiv un análisis de 137.293 votos decisivos en francés de Compar:IA, una arena pública francesa de comparación de modelos, con datos de julio de 2026.
- En una arena, el usuario ve dos respuestas anónimas a la misma pregunta y vota por una. Con esos votos se arma un ranking.
- Los autores reconstruyeron la respuesta que cada usuario tenía a la vista al votar y midieron formato, largo, legibilidad, variedad de vocabulario y estructura de las oraciones.
- Dos rasgos se mantuvieron estables en todas las especificaciones: cada desviación estándar de uso de negritas sube 11% las probabilidades de ganar, y la variedad de vocabulario las sube 16,8%.
- Ajustar por todos esos rasgos mueve 36 de 116 modelos al menos 10 lugares. El ranking ajustado, sin embargo, no coincide mejor con otras pruebas de capacidad.
Por qué importa
- Una arena mide preferencia, no capacidad, y la preferencia incluye cómo se ve la respuesta. Quien elige proveedor mirando un ranking de este tipo está comprando, en parte, presentación.
- Para equipos en Chile que eligen modelo para atención o contenidos en español, el estudio ofrece un criterio práctico: si la tarea premia respuestas bien presentadas, el ranking crudo sirve. Si premia exactitud, hay que probar con casos propios.
- La conclusión de los autores es incómoda para ambos lados: el ranking crudo sobrevalora el formato, pero el ajustado tampoco mide mejor. Recomiendan publicar los dos juntos.
El dato
36 de 116. Modelos que se mueven 10 o más lugares cuando el ranking se ajusta por formato y estilo.
Contexto
Largo, negritas y listas suelen venir juntos, lo que hace difícil separar el efecto de cada uno. El efecto de las negritas es bastante menor en conversaciones de varios turnos, aunque los autores advierten que esa diferencia es descriptiva y no causal. La fragilidad de las cifras de evaluación ya apareció en otros terrenos: el riesgo declarado de un modelo cae hasta 37 puntos según cómo se promedie, y dos motores de IA nombran la misma marca en 81% y 43% de sus respuestas.
Qué viene
- Los autores proponen publicar rankings crudos y ajustados lado a lado como análisis de sensibilidad.
- El paper es un preprint en versión 1.
- Sin plazos anunciados para que Compar:IA adopte esa recomendación.
Cierre
Un ranking construido con votos ciudadanos termina premiando lo que se lee rápido. Es el mismo sesgo que cualquier editor conoce, solo que ahora decide qué modelo se compra.
Fuentes
Editado por Rodrigo Cornejo. Cómo trabajamos: quiénes escriben las notas.