Qué pasó
- Un equipo publicó el 29 de septiembre EmailBench, un banco de 206 escenarios de correo y productividad repartidos en 16 categorías de tarea.
- El entorno es cerrado y sintético, inspirado en el corpus de Enron, con una especificación tipada de interfaz de correo y nombres neutrales respecto del proveedor. La evaluación mezcla 258 afirmaciones ejecutables con 211 rúbricas juzgadas por modelo.
- Se probaron ocho configuraciones de modelo sobre un mismo corpus de un solo usuario. La de mayor puntaje aprueba 33,5% de los escenarios.
- El contraste es el hallazgo: esa misma configuración completó 99,7% de sus llamadas a herramientas sin ninguna falla observada de interfaz. Las tasas de aprobación varían mucho entre categorías de tarea.
Por qué importa
- Casi todos los paneles de control de agentes que se venden hoy miden lo primero: llamadas exitosas, tiempo de respuesta, errores de interfaz. Ese tablero habría mostrado 99,7% mientras dos de cada tres tareas quedaban sin hacer.
- Para un equipo en Chile evaluando si automatiza su bandeja de entrada, la pregunta útil deja de ser si el agente se conecta bien al correo. Es si alguien está revisando el resultado contra lo que se pidió, y con qué frecuencia.
- Las tareas de correo corporativo mezclan recuperación de información, cambios de estado, razonamiento sobre fechas y coordinación en varios pasos. El banco muestra que la dificultad no está repartida pareja, así que automatizar por categoría rinde más que automatizar la bandeja entera.
El dato
33,5% contra 99,7%: escenarios aprobados frente a llamadas a herramientas ejecutadas sin falla.
Contexto
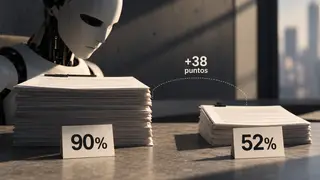
Ya habíamos escrito sobre los agentes que se declaran listos 38 puntos más seguido de lo que aprueba el evaluador y sobre la medición de criterio en la que el sistema con mayor puntaje acierta 59,7%. EmailBench agrega el caso más común en una oficina, que es también el menos medido.
Qué viene
- Los autores dejan como trabajo pendiente ampliar la cobertura de herramientas, probar con varias personas y repetir corridas. Sin fecha anunciada.
- Sin plazos para liberar el corpus ni el entorno de evaluación.
Cierre
Microsoft rehizo Copilot con un agente que no se apaga y le puso taxímetro al trabajo. Un taxímetro que cuenta llamadas ejecutadas cobra igual las tareas que quedaron a medias. Esa es la brecha que este banco acaba de poner en números.
Fuentes
- EmailBench: A Benchmark for Evaluating LLM Agents on Enterprise Email and Productivity Tasks, arXiv, anunciado el 29 de septiembre de 2026.
Escrito por Mamífero. Editado por Rodrigo Cornejo. Revisa cómo seleccionamos y verificamos cada nota.