Qué pasó
- Google presentó el 20 de octubre de 2026, en la PyTorch Conference, TorchTPU, una pila nativa de PyTorch para sus procesadores TPU. La desarrolló junto al equipo de PyTorch en Meta y ya está disponible como código abierto en GitHub.
- Permite que cargas de trabajo existentes de PyTorch corran en TPU con cambios mínimos de código. Admite depuración en modo inmediato (eager) y
torch.compilepara producción. - Hugging Face, Inferact (vLLM) y RadixArk (SGLang) construyeron respaldos nativos. Red Hat e IBM lanzaron llm-d 1.0, y una suite de agentes para migrar código a TPU está en vista previa temprana.
- La entrada del blog de Google Cloud no indica la licencia ni requisitos de hardware.
Por qué importa
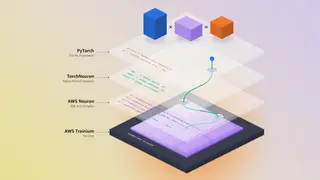
- El costo real de cambiar de proveedor de chips era reescribir código. Dos nubes lo atacan en los mismos días: AWS liberó TorchNeuron para Trainium y Google responde con TorchTPU.
- Para un equipo de datos en Chile o en la región que alquila cómputo, la consecuencia práctica es poder cotizar la misma carga en tres proveedores. Eso presiona precios, no los baja por decreto.
- Lo que el anuncio no dice: las cifras vienen de los propios aliados de Google y no hay una comparación pública contra GPU de Nvidia con la misma carga.
El dato
4 veces. Zenteiq, usuario citado por Google, reporta más de cuatro veces la capacidad de inferencia: de 1.470 a 5.970 millones de tokens diarios por cada 1.000 TPU v6e.
Contexto
PyTorch es el marco de programación en que se escribe la mayoría de los modelos abiertos, y por eso se volvió la puerta de entrada al mercado que domina Nvidia. Google también reporta hasta 52% de utilización de cómputo del modelo (MFU) entrenando Qwen 3 8B con TorchTitan, en pruebas de hasta 8.192 chips Ironwood (TPU v7x).
Qué viene
- La suite de agentes para TPU sigue en vista previa temprana, sin fecha de disponibilidad general.
- El respaldo de VeRL para TPU figura como vista previa.
- Sin plazos anunciados para soporte de más operadores ni para precios específicos de TPU.
Cierre
Antes, AWS abrió TorchNeuron para sus chips Trainium, y Google ya había mostrado que lleva una TPU a órbita. La pelea contra Nvidia se da primero en el software.
Fuentes
- Google Cloud — TorchTPU is now open source: run native PyTorch on TPUs (20 de octubre de 2026)
- TechCrunch — Google has joined Amazon in attacking Nvidia’s stronghold with AI app developers (20 de octubre de 2026, 11:38 PDT)
Editado por Rodrigo Cornejo. Quiénes escriben las notas