Qué pasó
- Un trabajo publicado el 20 de octubre de 2026 presenta MemT-1.0, una familia de modelos que incorpora la memoria como parte de su arquitectura. El paper figura como arXiv 2610.26825.
- Hay dos tamaños: Nano, con 36.000 millones de parámetros (3.000 millones activos) y memoria dinámica de 10 millones, y Flash, con 288.000 millones (17.000 millones activos) y memoria dinámica de 336 millones.
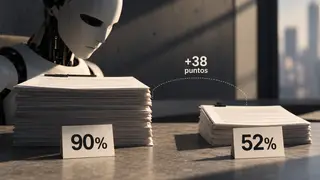
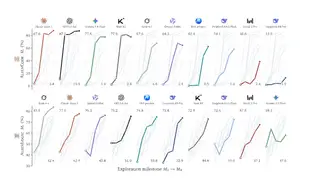
- En 11 pruebas de memoria, Flash promedia 50,6 puntos y Nano 47,0. Los autores los ubican primero y segundo entre los métodos de memoria paramétrica, los que guardan el historial en los pesos del modelo.
- Con 128.000 tokens de historial, Nano reduce cerca de 66 veces el almacenamiento por trayectoria y acelera 1,86 veces la inferencia, frente a un caché KV completo.
Por qué importa
- Un agente que trabaja días con una empresa acumula historial. Guardarlo como texto y volver a leerlo en cada paso consume tokens, que es lo que se factura. La propuesta ataca ese costo en origen.
- El texto del paper admite un límite que conviene leer: los sistemas de memoria textual todavía puntúan más alto en pruebas de historial largo, como LongMemEval-S y BEAM-1M. La ventaja es de eficiencia, no de exactitud.
- Para una pyme que evalúa un asistente con memoria, la pregunta útil es qué se pierde al comprimir. Un historial guardado en pesos no se puede leer, auditar ni borrar con la facilidad de un archivo de texto, algo que importa si hay datos de personas.
El dato
66 veces. Reducción de almacenamiento por trayectoria del modelo Nano frente a un caché KV completo, con 128.000 tokens de historial.
Contexto
La memoria de los agentes ya venía mostrando grietas. Un método sin entrenamiento subió la recompensa de agentes que pierden su razonamiento con el contexto, y LongHarness midió cuánto cuesta cada arnés de contexto largo. MemT intenta resolver el mismo problema cambiando el modelo, no el montaje que lo rodea.
Qué viene
- El texto no aclara si los pesos y el código se publicarán, ni bajo qué licencia.
- Sin fechas anunciadas. Una réplica externa de las 11 pruebas decidirá cuánto de la cifra sobrevive.
Cierre
La memoria de un agente se sigue resolviendo en dos frentes: arneses más afinados afuera o modelos que recuerdan por dentro. MemT apuesta por lo segundo, y deja a los sistemas de texto como referencia en las pruebas largas.
Fuentes
Editado por Rodrigo Cornejo. Quiénes escriben las notas