Qué pasó
- Un trabajo publicado en arXiv el 24 de septiembre presenta ExplorationBench, un conjunto de pruebas para medir si un sistema de IA explora o solo recuerda. Lo firma un equipo de veinte autores encabezado por Ming Zhang.
- El diseño resuelve dos problemas de medición a la vez: cómo verificar una hipótesis nueva y cómo distinguir el descubrimiento del recuerdo.
- La solución son «mundos alienígenas» verificables. Las reglas son ejecutables, así que toda respuesta se comprueba de forma exacta, y contradicen el conocimiento familiar, así que la memoria no alcanza para resolverlas.
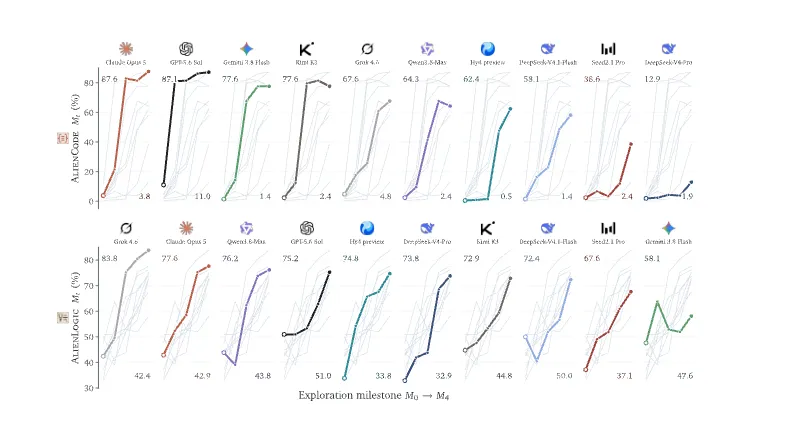
- Son dos entornos: AlienCode, con 31 objetivos de descubrimiento y 70 tareas, y AlienLogic, con 24 objetivos y 70 tareas. Cada uno entrega manuales con errores deliberados, retroalimentación del entorno y esquemas de herramientas.
- Sobre diez sistemas evaluados, los mejores adquieren y aplican reglas desconocidas, pero el desempeño fluctúa de forma marcada entre trayectorias y algunos empeoran al seguir explorando.
Por qué importa
- La inestabilidad entre intentos es el hallazgo con consecuencias prácticas. Si un sistema resuelve una tarea y falla la misma tarea en otro intento, cualquier promesa de autonomía en un proceso de negocio necesita un mecanismo de reintento y verificación que hoy nadie está presupuestando.
- Los manuales con errores deliberados imitan la condición real de trabajo en cualquier organización: documentación desactualizada y reglas que nadie escribió. Un banco de pruebas que castiga confiar en el manual mide algo que las evaluaciones limpias no ven.
- El caso de sistemas que empeoran al explorar más contradice el supuesto de que más pasos e iteraciones mejoran el resultado. Quien esté dimensionando presupuesto de inferencia por tarea debería mirar ese dato antes de escalar.
El dato
140 tareas repartidas en dos entornos con 55 objetivos de descubrimiento.
Contexto
Las evaluaciones de agentes vienen chocando con el mismo problema: los conjuntos de prueba terminan filtrados en los datos de entrenamiento y la exactitud sube sin que la capacidad cambie. La respuesta de este año fue construir entornos ejecutables y verificables en vez de listas de preguntas. Aquí se agrega un giro: las reglas están diseñadas para contradecir lo aprendido.
Qué viene
- El trabajo está disponible en arXiv desde el 24 de septiembre. Sin plazos anunciados para liberar los entornos ni una tabla pública de resultados.
Cierre
Medir exploración exige un mundo donde nadie haya estado antes, y construir ese mundo es más difícil que construir el modelo que lo recorre. Por eso casi todas las evaluaciones siguen premiando memoria.
Fuentes
- «ExplorationBench: Measuring AI Systems’ Exploration in Verifiable Alien Worlds», arXiv 2609.30199
- Nuestra cobertura previa: la prueba de criterio estético en agentes, los modelos que no reconocen su propio código y el caso Navier-Stokes sin comprensión del problema.
Editado por Rodrigo Cornejo. Cómo seleccionamos y verificamos: quiénes escriben estas notas.