Qué pasó
- Un equipo de la Universidad de Virginia, la Biblioteca Nacional de Medicina de los Institutos Nacionales de Salud de Estados Unidos, la Universidad de Illinois y el Dana-Farber Cancer Institute publicó el 28 de octubre de 2026 en Nature Communications un estudio sobre cómo entrenar agentes de búsqueda.
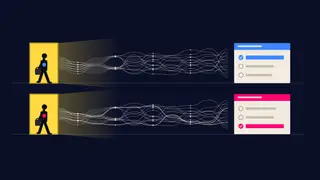
- Los autores presentan RAG-Gym, un marco que traslada la supervisión desde la respuesta final hacia el propio proceso de búsqueda: qué consulta hace el agente, qué lee y cómo decide el paso siguiente.
- Con ese marco estudiaron tres frentes: el diseño de la arquitectura del agente, la optimización de sus parámetros y la evaluación de cada acción.
- El resultado es Re2Search++, un agente supervisado por proceso que, según el artículo, mejora de forma sustancial en pruebas de búsqueda de información de varios pasos, sobre todo fuera del dominio en que se entrenó.
Por qué importa
- Los modelos de lenguaje están cambiando la búsqueda en la web: en vez de ordenar documentos, sintetizan respuestas, y cada vez más funcionan como agentes que consultan fuentes externas una y otra vez.
- El método habitual premia al agente solo cuando acierta la respuesta final. Los autores sostienen que eso provoca trampas en la recompensa y una dependencia excesiva de lo que el modelo ya memorizó, lo que limita su desempeño ante temas nuevos.
- El hallazgo central es práctico: las mejoras vienen sobre todo de consultas de búsqueda de mejor calidad, no de pulir la respuesta. Un agente que pregunta mejor encuentra mejores fuentes.
- Los evaluadores de búsqueda que aprendió el sistema se transfirieron a otros modelos, incluidos modelos propietarios. Eso permitiría usar el mismo crítico para mejorar agentes de distintos proveedores.
El dato
3 frentes de diseño. RAG-Gym examina por separado la arquitectura del agente, la optimización de parámetros y la evaluación de acciones, y en ese análisis identifica la reflexión sobre el razonamiento como capacidad decisiva.
Contexto
La generación aumentada por recuperación, conocida como RAG, combina un modelo de lenguaje con un buscador que le entrega documentos antes de responder. Los agentes de búsqueda llevan esa idea más lejos: deciden ellos mismos cuántas veces buscar, qué preguntar y cuándo detenerse.
El problema que aborda el estudio es que los pasos intermedios de buena calidad son difíciles de generar y de evaluar. Si solo se mira el resultado, un agente puede acertar por casualidad, o por memoria, y aprender malos hábitos de búsqueda que fallan en cuanto cambia el tema. La supervisión del proceso intenta corregir eso al evaluar cada consulta y cada decisión.
La participación de la Biblioteca Nacional de Medicina y de un centro oncológico sugiere un interés en búsquedas biomédicas, donde una respuesta correcta por las razones equivocadas puede ser un riesgo.
Qué viene
- El artículo no reporta, en su resumen, el costo computacional de supervisar cada paso, un dato que decidirá su uso en productos.
- La transferencia de los críticos a modelos propietarios abre la puerta a que equipos pequeños mejoren agentes sin reentrenar el modelo base.
Cierre
El entrenamiento de agentes se mueve hacia premiar el camino y no solo la meta: ThinkingBox premia al agente por la base de datos que deja y GRAFT deja que un modelo haga trampa y luego borra esos atajos. Sobre el comportamiento de los agentes de investigación, ver qué hace un agente cuando el usuario ya se fue y cómo borrar razonamiento viejo baja 25,5% los tokens.
Fuentes
- Nature Communications — Supervising the search process produces reliable and generalizable information-seeking agents (Xiong et al., 28 de octubre de 2026; fecha confirmada en Crossref)
- Imagen de portada: TBurmeister (WMF), CC BY-SA 4.0, vía Wikimedia Commons
Editado por Rodrigo Cornejo. Quiénes escriben las notas