何が起きたか
- 端末上で動くモデルを開発するスタートアップのUnderdogは、31.7 MBのテキスト読み上げモデル、Woofを発表した。TechCrunchが2026年11月6日に報じた。
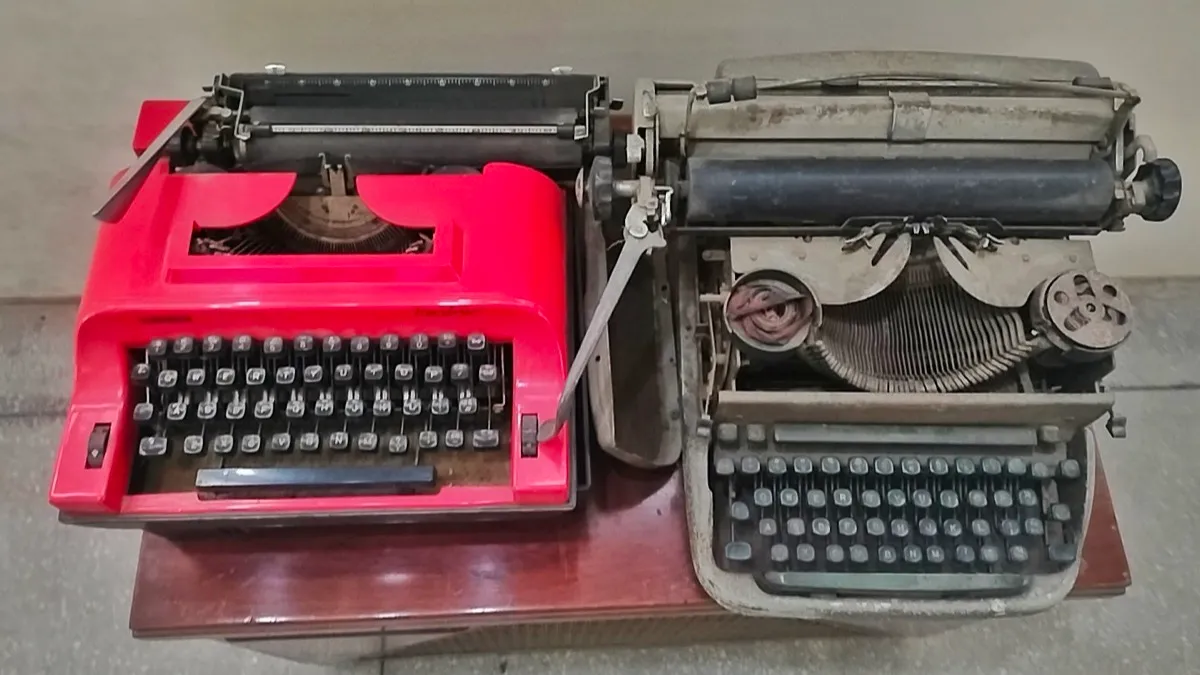
- 同社は、タイプライター、CRTモニター、デスクランプのあるレトロ調の部屋を舞台にしたゲームでこれを披露した。ユーザーがキーボードで入力した内容を、モデルが読み上げる。
- 同社によると、このモデルは3100万パラメータで、インターネット接続なしでほとんどの端末で動作し、オープンだ。誰でもダウンロードできる。
- このデモは、Barkの数週間後に行われた。Barkは、これも端末向けに設計された167 MBの音声テキスト変換モデルだ。
なぜ重要か
- 大規模モデルの競争は、膨大な計算能力を必要とする。並行するもう一つの流れである小型モデルは、データをクラウドに送らずに、スマートフォンやパソコンでAIを動かそうとしている。
- ブラウザのタブに収まる音声モデルがあれば、アシスタント、テキストの読み上げ、パーソナライズされたポッドキャストといったローカルな体験が、サーバーを介さずに実現できる。
- TechCrunchは、これほど小さなモデルが大型モデルに取って代わることはおそらくないが、こうした用途には十分かもしれないと注意を促している。
数字で見る
31.7 MB。 Woofの大きさだ。あまりに小さいので、ゲームはブラウザの中で動く。Underdogによると、ゲームの中の声はすべてモデル自身が生成している。
背景
Underdogの創業者Sigil Wenは、TechCrunchに対し、Granolaのような議事録ツールを使う代わりに、端末上で動くモデルで自分のシステムを作り、データをユーザーの手元に残したいと考え、このアプリを作り始めたと語った。
「今日の最も高性能なモデルの大半を、すでに持っている端末で動かせるようになるのは数か月以内だと思う」とWenは述べた。これは創業者の予測であり、測定された結果ではない。同社は、ノートパソコンで動く270億パラメータのモデルと、待機リスト制のアプリも公開した。後者はMuseやInstinctに対するローカルな代替として位置づけている。
実証されていることと約束されていることを分けて考えると分かりやすい。今日確認できるのは、モデルの大きさと、ブラウザで動くことだ。ほかのオープンな選択肢と比べた声の品質は、TechCrunchの記事では測定されていない。
関連する話題として、MamíferoはPhononがオフラインで音声を生成、わずか75 MB、NVIDIAがNemotron 3.5 Transcribeをオープンモデルとして公開、Recursiveがノートパソコンで動くコーディングモデルFlintを公開、A5が、文脈を覚えているデスクトップアシスタントを提案を掲載している。
今後
- Woofの品質をほかのオープンな音声モデルと比べた、独立した比較はまだない。
- 同社のローカルアプリは、引き続き待機リスト制だ。
- Wenの予測が当たれば、高性能なモデルは数か月のうちにサーバーに依存しなくなる。
まとめ
32 MBの音声モデルは、ブラウザのタブに収まり、インターネットなしで動く。その有用性を決めるのは大きさではなく、クラウド上のモデルと並べたときにどれだけ良く聞こえるかだ。
出典
- TechCrunch「Underdog shows off a 32MB speech model in new demo」2026年11月6日、リンク。
- カバー画像:পাপৰি বৰা、CC BY-SA 4.0、Wikimedia Commonsより
編集:Rodrigo Cornejo。選定と検証の方法:ノートを書いているのは誰か。