Qué pasó
- A fines de julio de 2026, Mercor y Ramp publicaron en arXiv APEX-Accounting, un banco de 160 tareas repartidas en 10 empresas simuladas con sistemas contables completos.
- Las tareas replican el trabajo de un cierre: conciliar cuentas, provisionar gastos, registrar transacciones y armar informes. Contadores expertos escribieron y corrigieron cada una.
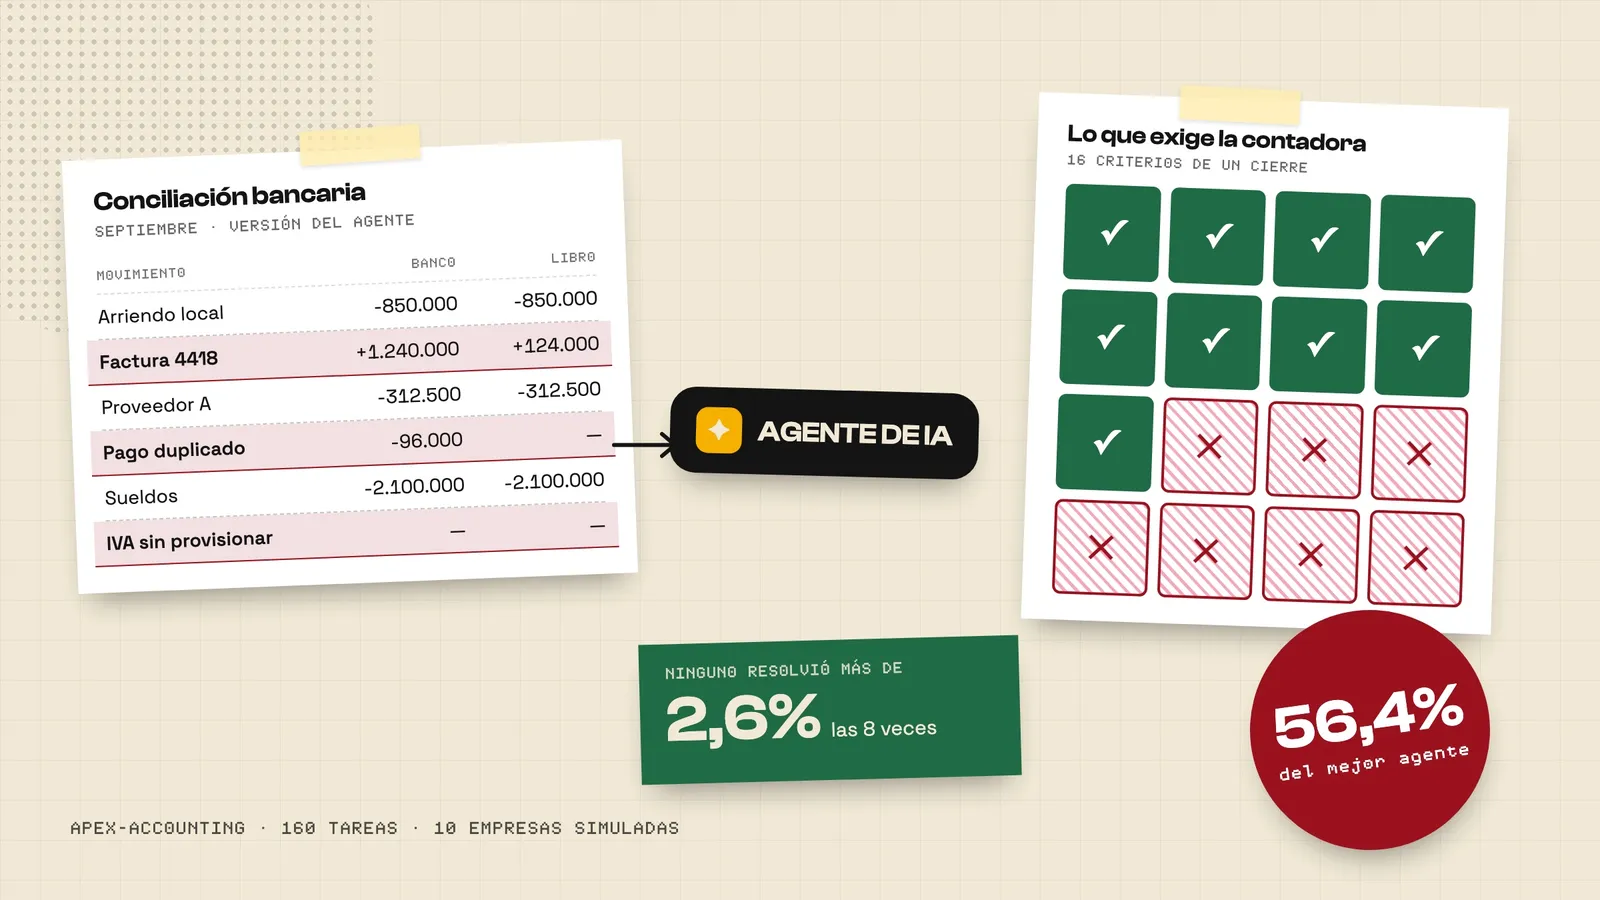
- El mejor resultado es el de Claude Fable 5 (Max): 56,4% de los criterios binarios escritos por expertos, promediado sobre tres de ocho corridas tomadas al azar. Le sigue Muse Spark 1.1, con 52,6%.
- La consistencia es peor. El resumen del trabajo informa una mejor tasa Pass@8 de 21,5% y que ningún modelo supera 2,6% de tareas resueltas cuando se exige acertar en las ocho corridas.
Por qué importa
- 56% de los criterios no es «casi bien». En una conciliación, cada criterio incumplido es una diferencia que aparece en el cierre, en el pago de impuestos o en la conversación con el banco. Para una pyme, ese descuadre lo paga quien no lo vio.
- Lo más útil del estudio es la consistencia. Un mismo trabajo que sale distinto en cada corrida obliga a que alguien compare el resultado con la realidad, y esa revisión es un costo que hay que presupuestar antes de comprar la licencia.
- Tres criterios sirven para decidir dónde usar un agente contable hoy:
- Empezar por tareas de baja consecuencia, como clasificar gastos para una primera pasada, y dejar la conciliación final en manos de una persona.
- Pedirle al proveedor trazabilidad: qué asiento hizo, con qué documento y por qué.
- Medir en la propia empresa. Tomar un mes ya cerrado, dárselo al agente y comparar con el cierre real antes de usarlo en el mes en curso.
- El estudio tiene límites. Las empresas son simuladas y estadounidenses, sin normativa tributaria chilena ni relación con el SII. Ramp, además, vende software financiero con IA, así que tiene interés en el tema, aunque el trabajo publica metodología y resultados por modelo.
El dato
56,4% frente a 2,6%. El mejor puntaje medio por criterio, contra el máximo de tareas que un modelo resuelve en las ocho corridas.
Contexto
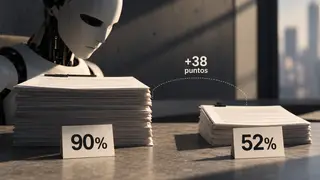
Es la tercera medición reciente que separa hacer y hacer bien. En EmailBench, los agentes de correo ejecutaron 99,7% de sus llamadas pero resolvieron 33,5% de las tareas. Otra medición mostró agentes que se declaran listos 38 puntos más seguido de lo que aprueba el evaluador. Los autores de APEX-Accounting agregan un hallazgo de costo: un presupuesto mayor de tokens sube el puntaje, pero dentro de un mismo presupuesto las tareas que consumen más tokens salen peor.
Qué viene
- Sin fecha anunciada para nuevas corridas ni para una versión con normativa fuera de Estados Unidos.
- Mercor mantiene una tabla de posiciones pública del banco, donde se verían los modelos nuevos.
Cierre
Un agente contable puede ahorrarle horas a una pyme. Antes de firmar el cierre, su resultado tiene que ponerse en la misma mesa que el de la contadora.
Esta nota describe un estudio publicado y no constituye asesoría contable ni tributaria.
Fuentes
- APEX-Accounting, arXiv, versión 2 del 30 de julio de 2026
- Introducing APEX-Accounting, built with Ramp, Mercor
- APEX–Accounting, Ramp Labs
Escrito por Mamífero. Editado por Rodrigo Cornejo. Revisa cómo seleccionamos y verificamos cada nota.