Qué pasó
- Un trabajo publicado en arXiv el 24 de septiembre describe un procedimiento de preentrenamiento que no usa datos de partida. Firman Aditya Cowsik, Kfir Dolev, Michael Y. Li, G. Bruno De Luca, Nourya Cohen, Noah D. Goodman y Yoav Levine.
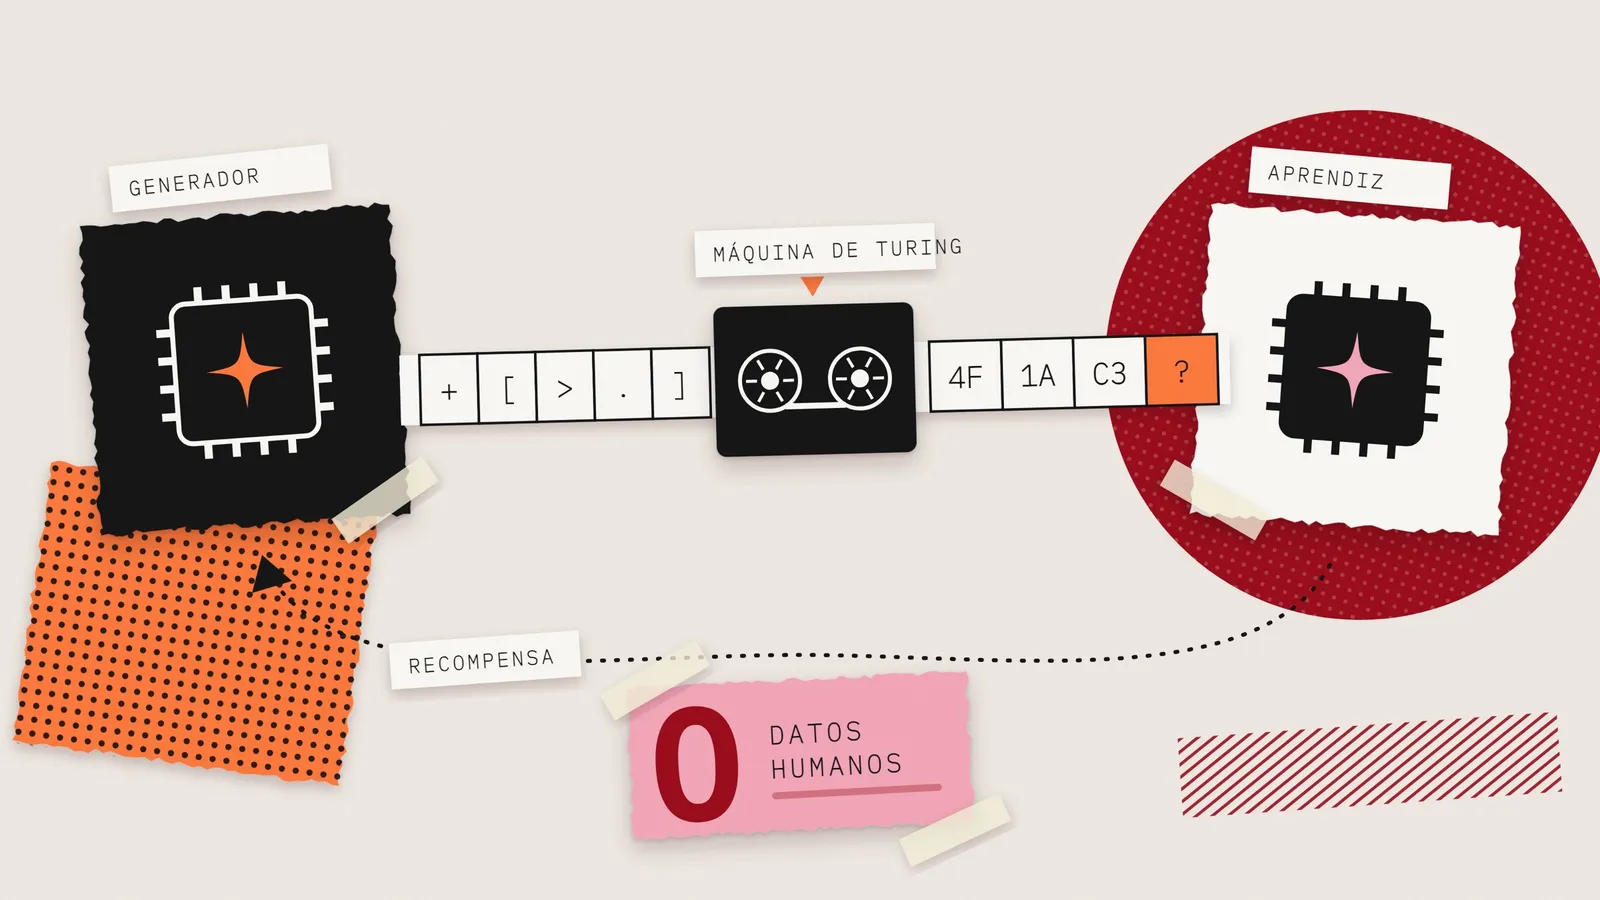
- El montaje tiene dos modelos que aprenden en paralelo desde inicialización aleatoria. Uno propone programas que una máquina de Turing universal interpreta para generar secuencias de bytes; el otro predice esas secuencias.
- El generador se entrena por refuerzo para producir secuencias justo en el límite de lo que el aprendiz puede resolver. Eso arma un currículum que se ajusta solo a medida que el aprendiz mejora.
- Los autores reportan que el desempeño en datos naturales mejora de forma predecible con el cómputo invertido en el autojuego, y que aparecen aprendizaje en contexto y secuencias matemáticas reconocibles durante el entrenamiento.
- El propio trabajo se presenta como prueba de concepto inicial, no como alternativa al preentrenamiento vigente.
Por qué importa
- Si la fuente de datos deja de ser el texto disponible y pasa a ser el cómputo, la ventaja competitiva se mueve de quién tiene archivo a quién tiene capacidad instalada. Para la región eso es una mala noticia: el archivo se puede licenciar; los centros de datos hay que construirlos.
- Todo el debate sobre derechos de autor en el entrenamiento supone que los datos vienen de alguna parte y que alguien los reclama. Un procedimiento sin corpus de partida no resuelve los litigios abiertos, pero define un carril donde no aplican.
- Para quien compra modelos, el punto práctico es otro: un currículum autogenerado no trae la sesgadura de un corpus, y tampoco trae su cobertura. Nadie puede auditar todavía qué queda afuera.
El dato
0 ejemplos de datos humanos en el punto de partida del procedimiento.
Contexto
La discusión sobre el fin de los datos de entrenamiento venía resolviéndose por dos vías: comprar licencias y generar datos sintéticos a partir de modelos ya entrenados. Este trabajo prueba una tercera, que no depende de un modelo maestro previo sino de una búsqueda sobre el espacio de estructuras computables, con la inducción de Solomonoff como referencia teórica.
Qué viene
- El trabajo está disponible en arXiv desde el 24 de septiembre. Sin plazos anunciados para escalar el procedimiento ni para una versión con revisión por pares.
Cierre
El preentrenamiento sin datos suena a truco de laboratorio y probablemente lo sea por varios años. Lo que no es truco es la curva: si mejora con cómputo y no con archivo, cambia la lista de quiénes pueden competir.
Fuentes
- «Self-Play Pretraining with Zero Data», arXiv 2609.30063
- Nuestra cobertura previa: la ronda de 350 millones de Snorkel por datos de entrenamiento, las restricciones de Estados Unidos a la destilación de modelos y el plan gratuito de Mistral que entrena con conversaciones.
Editado por Rodrigo Cornejo. Cómo seleccionamos y verificamos: quiénes escriben estas notas.