Qué pasó
- Un estudio anunciado el 29 de septiembre evalúa si modelos de pesos abiertos generan encuestados sintéticos que conserven la estructura estadística humana, y no solo respuestas verosímiles.
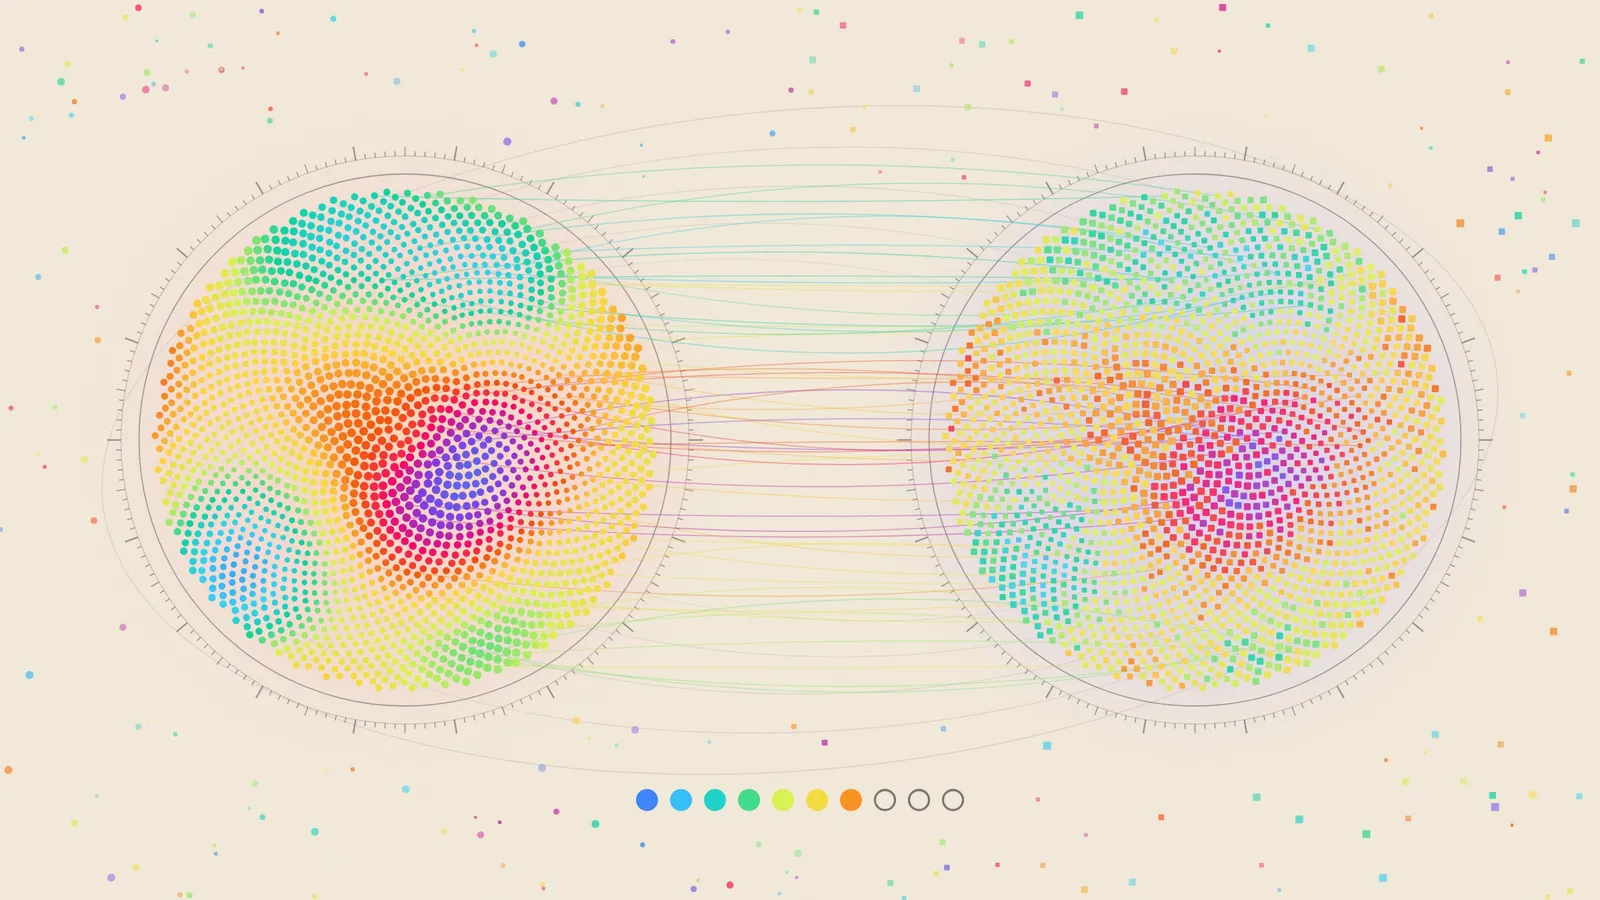
- El método condiciona cada persona simulada con las respuestas textuales de un encuestado real a un instrumento psicométrico, y luego la mide con un segundo instrumento distinto, controlando la distancia entre constructos. El contraste es un panel humano de 2.058 personas.
- Sobre una grilla de 139 pares, la correlación cruzada simulada sigue a la humana real con r entre 0,70 y 0,73 en las tres familias probadas. El resultado se apoya sobre todo en acertar el signo y se concentra en pares de distancia media.
- El hallazgo incómodo: la capacidad no mejora de forma sostenida entre versiones. En un panel pareado, la más reciente de tres versiones de Llama probadas rinde peor en dos de las tres métricas principales.
Por qué importa
- Reproducir el signo no es reproducir la magnitud. Sirve para ordenar hipótesis antes de salir a terreno; no sirve para reemplazar la muestra ni para reportar un porcentaje.
- La advertencia sobre versiones es la parte operativa: actualizar el modelo puede empeorar el estudio sin que nada en el proceso avise. Los autores piden verificación específica por versión y consciente de la distancia entre constructos, no una validación hecha una sola vez.
- Para equipos en Chile que hacen investigación con muestras caras, el uso razonable es acotado y conviene decirlo: priorizar qué preguntar, no publicar cuánto respondió quién.
El dato
r entre 0,70 y 0,73 en las tres familias de modelos abiertos evaluadas.
Contexto
Ya habíamos escrito sobre un simulador de público que anticipa hasta 90% de las críticas a un lanzamiento. Este trabajo aporta el reverso: mide qué parte de la estructura humana efectivamente se conserva, con un panel real de contraste y modelos que cualquiera puede descargar.
Qué viene
- Sin fecha anunciada para liberar la grilla de 139 pares ni el protocolo de calibración.
- Sin plazos para extender el estudio a modelos cerrados.
Cierre
El estudio de inteligencia artificial de Forbes Chile afirmó que 34 es el doble de 30. Una muestra sintética con r de 0,70 y una muestra real mal leída fallan distinto, pero terminan en la misma lámina de presentación. La diferencia la hace quien reporta el margen.
Fuentes
- Can Open-Weight Large Language Models (LLMs) Simulate Human Survey Populations? A Cross-Instrument Calibration Study, arXiv, anunciado el 29 de septiembre de 2026.
Escrito por Mamífero. Editado por Rodrigo Cornejo. Revisa cómo seleccionamos y verificamos cada nota.